Par Andréanne Bergeron, chercheuse en sécurité
Vous saisissez votre adresse e-mail pour obtenir une réduction de 10 %. Vous communiquez votre numéro de téléphone pour vérifier un compte. Vous entrez votre nom sur un formulaire d'inscription. Chaque divulgation semble insignifiante car, prise individuellement, elle l'est : une adresse e-mail coûte 0.0002 $ sur le dark web, et un nom à peu près autant. Mais lorsqu'elles sont combinées lors d'une fuite de données, le prix ne double pas, il explose. Une nouvelle étude portant sur 318 fuites révèle que les ensembles de données volées valent systématiquement plus que la somme de leurs parties.
Principaux enseignements concernant l'intérêt de combiner les informations personnelles identifiables
- La valeur des données personnelles est supra-additive : les données combinées valent bien plus que la somme de leurs parties. 52 % des violations de données personnelles impliquant plusieurs informations personnelles se vendent à un prix supérieur à la somme des prix des informations personnelles individuelles, même en prenant des estimations prudentes.
- La combinaison spécifique des types de données importe plus que la quantité de données exposées ; la structure est plus déterminante que la taille.
- Le principal risque ne réside pas dans l'exposition individuelle des données, mais dans l'agrégation des données provenant de multiples sources apparemment inoffensives.
- Les divulgations de données quotidiennes (par exemple, les remises, les formulaires d'inscription, les programmes de fidélité) peuvent devenir très risquées lorsqu'elles sont combinées au fil du temps.
Renseignements sur les menaces axés sur l'identité
Suivez l'exposition cumulative des données de votre organisation suite à des violations de données.
Une fuite d'emails semble mineure. Mais si l'on y ajoute des numéros de téléphone issus d'une seconde fuite et des noms provenant d'une troisième, les attaquants détiennent la combinaison la plus précieuse du marché noir : une valeur des milliers de fois supérieure à celle de ses éléments constitutifs. Flare surveille les marchés du dark web, les bases de données de fuites de données et les journaux des voleurs pour détecter l'agrégation des données de votre organisation provenant de différentes sources, avant qu'elles ne soient utilisées à des fins d'usurpation d'identité par échange de carte SIM, d'hameçonnage ciblé ou de prise de contrôle de compte.
L'affirmation : « Je n'ai rien à cacher »
« Je n’ai rien à cacher » est une justification courante pour minimiser les inquiétudes concernant les données personnelles. Cela reflète la conviction que les données individuelles ont peu de valeur. Prise isolément, cette affirmation n’est pas totalement fausse : sur les marchés illicites, une adresse électronique ou un nom peuvent s’échanger pour une somme dérisoire.
Cependant, cette perspective repose fondamentalement sur une incompréhension des mécanismes par lesquels les données acquièrent de la valeur. Les données personnelles fonctionnent de manière multiplicative et non additive. Autrement dit, une fois combinées, des éléments a priori insignifiants forment des profils cohérents et hautement exploitables.
Notre équipe de recherche a analysé 348 violations de sécurité documentées, identifiant 88 types distincts d'informations personnelles identifiables (IPI) et déterminant un prix par utilisateur sur le marché noir. Les conclusions sont sans équivoque : la valeur des IPI volées n'est pas additive. Les ensembles de données sont superadditifs, ce qui signifie que le tout vaut bien plus que la somme de ses parties (voir la description détaillée de la méthodologie dans [référence manquante]). Quel est le coût de vos données sur le Dark Web ?).
Le mythe des produits de base : pourquoi les assurances PII bon marché vous trompent
Le prix des données personnelles est bien connu : les informations de carte bancaire, les adresses e-mail et les numéros de sécurité sociale se vendent pour quelques euros, voire quelques centimes. S’il est intéressant de connaître la valeur de chaque donnée personnelle, cela ne permet pas d’appréhender pleinement l’impact réel des violations de données.
Nous savons que les attaquants acquièrent et exploitent les données par lots, et non de manière isolée, par exemple via un Bot Telegram automatisé qui utilise l'adresse électronique d'une victime et construit un profil plus complet à partir de plusieurs bases de données de violations de données.
Nos données le confirment sur 316 enregistrements de violations exploitables. Les prix issus de violations exposant un seul type d'informations personnelles varient considérablement (sur plusieurs ordres de grandeur), comme le montre le tableau ci-dessous.
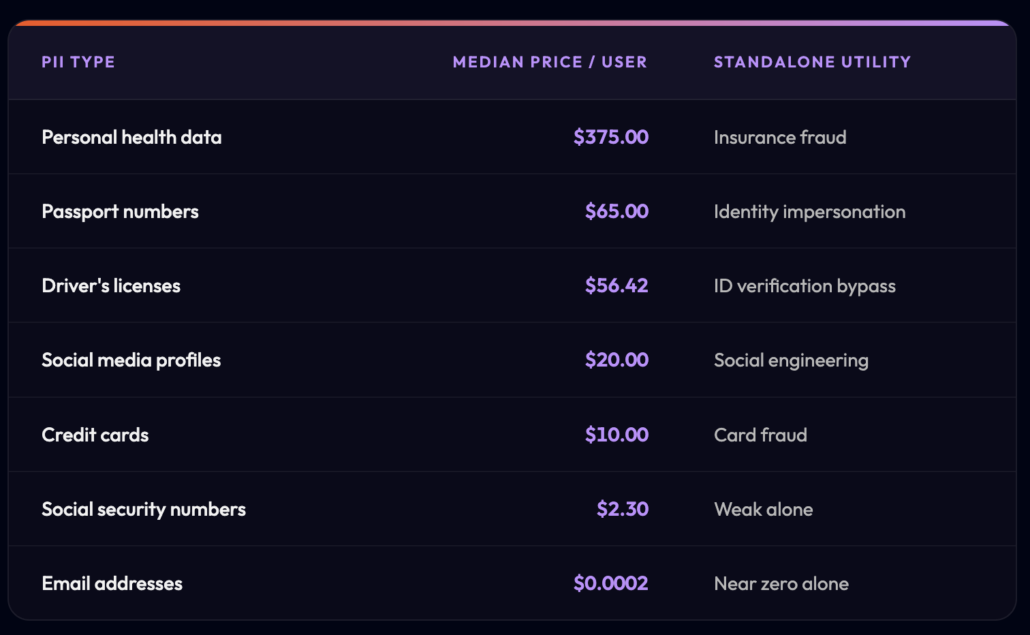
Les adresses e-mail et les numéros de sécurité sociale ont très peu de valeur pris isolément. Ce n'est pas qu'ils soient sans valeur, mais leur valeur dépend presque entièrement des informations auxquelles ils sont associés. Vendre une adresse e-mail seule, c'est obtenir une liste de spam. Ajouter un nom, c'est créer une cible pour le spear-phishing. Ajouter un numéro de téléphone, c'est exploiter une faille de sécurité pour le vol de carte SIM. Cette combinaison est nettement plus dangereuse.
Évaluation du surplus du paquet
Mesurer l'écart
Nous définissons le surplus du lot comme la différence entre le prix observé d'une violation de données et le prix auquel nous nous attendrions si nous additionnions simplement la valeur de chaque type de données pris individuellement.
Cette mesure est prudente pour deux raisons. Premièrement, de nombreuses violations de données incluent des types de données pour lesquels nous ne disposons pas de prix individuels fiables ; leur valeur n’est donc pas prise en compte dans le calcul. Deuxièmement, lorsque l’excédent est positif, cela signifie déjà que la violation a une valeur supérieure à la somme des valeurs individuelles connues, même avant de tenir compte des valeurs manquantes.
Les résultats montrent que dans 52 % des violations impliquant plusieurs types de données personnelles, le prix réel du marché dépassait la somme des prix individuels de chaque type de données. Les attaquants en tiennent déjà compte lorsqu'ils achètent des données volées.
La carte des paires : quelles combinaisons créent de la valeur ?
Pour valider notre approche, nous avons comparé plusieurs modèles de régression et constaté que les interactions entre les types de données personnelles expliquent une part nettement plus importante de la variation de la valeur d'une violation de données que les types de données personnelles pris individuellement ou la taille du lot (voir la section Méthodologie ci-dessous pour plus de détails). Nous avons donc étendu l'analyse afin d'identifier les combinaisons spécifiques de données personnelles qui génèrent la valeur la plus élevée lorsqu'elles sont utilisées conjointement.
Avec un nombre de variables presque égal au nombre d'observations, l'approche de régression standard s'avérait inadaptée, car elle ne permet plus de distinguer les interactions réelles du bruit. C'est pourquoi nous avons utilisé Lasso, une technique qui élimine automatiquement les variables faibles ou redondantes et ne conserve que celles ayant une réelle valeur prédictive. Sur 195 variables candidates, 47 ont été retenues. Une paire (Sexe × Statut matrimonial) s'est révélée suffisamment significative même sans ce filtrage, ce qui en fait la paire la plus robuste de l'ensemble de données.
Carte d'appariement
| Paire PII | Effect | Coefficient standard |
|---|---|---|
| Compléments | ||
| Adresses e-mail × Numéros de téléphone | ▲ Complément | +1.899 |
| Adresses e-mail × Noms | ▲ Complément | +0.733 |
| Cartes de crédit × Noms | ▲ Complément | +0.536 |
| Cartes de crédit × Adresses e-mail | ▲ Complément | +0.372 |
| Mot de passe × Numéros de téléphone | ▲ Complément | +0.177 |
| Soldes des comptes × Noms | ▲ Complément | +0.139 |
| Dates de naissance × Adresses physiques | ▲ Complément | +0.104 |
| Soldes des comptes × Adresses physiques | ▲ Complément | +0.059 |
| Mot de passe × Adresses physiques | ▲ Complément | +0.058 |
| Genres × Intitulés de poste | ▲ Complément | +0.046 |
| Genres × Statuts matrimoniaux | ▲ Complément | +0.031★ |
| substituts | ||
| Intitulés de poste × Adresses physiques | ▼ Remplaçant | -0.157 |
| Genres × Pièces d'identité délivrées par le gouvernement | ▼ Remplaçant | -0.106 |
| Dates de naissance × Noms d'utilisateur | ▼ Remplaçant | -0.100 |
| Informations sur l'appareil × Adresses e-mail | ▼ Remplaçant | -0.057 |
| Numéros de téléphone × Photos | ▼ Remplaçant | -0.018 |
À noter : l'interaction Genres × Statuts matrimoniaux est également significative dans le cadre de la méthode OLS standard (p=0.006), la seule interaction suffisamment robuste pour survivre sans régularisation.
Lecture de la carte de couplage
La paire la plus puissante (adresse e-mail × numéro de téléphone (β=+1.899)) n'est pas surprenante lorsqu'on analyse la chaîne d'attaque. L'e-mail seul permet le phishing. Le téléphone seul permet les arnaques par SMS. Ensemble, ils permettent de contourner l'authentification à deux facteurs par échange de carte SIM, d'effectuer des attaques par bourrage d'identifiants multicanal et de réaliser des hameçonnages vocaux avec confirmation par e-mail. Cette combinaison est qualitativement plus dangereuse que chacun de ses composants pris séparément.
L'adresse e-mail × nom (+0.733) reflète la préparation au spear-phishing, car les attaques personnalisées convertissent à des taux considérablement plus élevés que les génériques.
L'association d'un numéro de carte et d'un nom (+0.536) facilite la fraude en point de vente physique. Un numéro de carte suffit en ligne. L'ajout d'un nom permet de contourner la vérification physique en point de vente, un vecteur de fraude qualitativement différent et généralement plus lucratif.
Les soldes des comptes multipliés par les noms (+0.139) et les soldes des comptes multipliés par les adresses postales (+0.059) permettent, ensemble, de révéler la fraude financière : les données de solde identifient les comptes à cibler ; les données d’identité et d’adresse fournissent les éléments d’authentification nécessaires à la prise de contrôle. Aucun de ces éléments n’est suffisant à lui seul.
Le croisement Genre × Statut matrimonial mérite une attention particulière car il a résisté à la fois à l'analyse Lasso et aux moindres carrés ordinaires (OLS). Pris individuellement, ce croisement semble anodin puisqu'il s'agit de métadonnées démographiques. Combinées, ces deux informations personnelles permettent une segmentation précise de l'audience pour les campagnes d'ingénierie sociale, le profilage des fraudes à l'assurance et la création d'identités synthétiques imitant les tendances démographiques réelles.
Les paires de substitution : quand plus de données détruisent de la valeur
Toutes les combinaisons de données ne créent pas de valeur ; certaines en réduisent même la valeur. Lorsque deux types de données apparaissent fréquemment ensemble dans des violations de données de faible importance, leur cooccurrence indique que la violation est probablement peu utile aux attaquants.
L'association des intitulés de poste et des adresses postales illustre parfaitement ce phénomène. Cette combinaison est typique des bases de données RH ou des données extraites de profils comme ceux de LinkedIn : des informations sur le parcours professionnel sans mots de passe, données financières ni identifiants d'authentification. Bien que ces données puissent avoir une valeur dans certains contextes, elles sont, à elles seules, inutiles aux attaquants. Dépourvues d'éléments exploitables, elles sont généralement considérées comme des données de remplissage sans grande valeur.
Recommandations pour les équipes de sécurité
La nature superadditive des informations personnelles a des implications pratiques sur la manière dont les organisations classent, protègent et réagissent à l'exposition des données.
- Repenser l'évaluation de la gravité des violations de données. La plupart des analyses d'impact pondèrent le nombre d'enregistrements exposés. Cette étude démontre que la combinaison des champs est plus importante que leur nombre. Une violation de 10 000 enregistrements contenant une adresse électronique, un numéro de téléphone et un nom (β = +1.899 et +0.733 respectivement) peut représenter une menace réelle plus élevée qu'une violation de 100 000 enregistrements contenant uniquement des adresses électroniques. Les modèles de gravité doivent prendre en compte la présence simultanée de plusieurs champs dans un même enregistrement, et non seulement les champs exposés.
- Segmentez et isolez les paires de données à forte valeur ajoutée. La cartographie des paires permet d'identifier les combinaisons les plus recherchées par les attaquants. Dans la mesure du possible, évitez de stocker des types d'informations personnelles complémentaires dans la même base de données, la même table ou sous les mêmes contrôles d'accès. Si les adresses e-mail et les numéros de téléphone doivent coexister, considérez ce stockage comme une cible prioritaire, même s'il contient des champs traditionnellement considérés comme « sensibles », tels que des données financières.
- Surveillez l'agrégation des données provenant de différentes sources. Une faille dans votre programme de fidélité (noms et adresses électroniques) combinée à une faille dans votre système d'authentification (adresses électroniques et numéros de téléphone) offre à un attaquant un triplet de données à forte valeur ajoutée, sans qu'aucune des deux failles ne paraisse grave prise individuellement. Suivez l'exposition cumulée de votre organisation face à l'ensemble des incidents, et non pas seulement la gravité de chacun d'eux pris séparément.
- Communiquez le risque en termes d'agrégation. Pour justifier les investissements en sécurité auprès de la direction, le cadre superadditif fournit un langage concret : « Notre base de données clients associe l'adresse e-mail, le numéro de téléphone et le nom dans un même enregistrement pour 4 millions d'utilisateurs. D'après les prix du marché parallèle, cette combinaison vaut beaucoup plus par enregistrement que n'importe quel champ pris individuellement. Le modèle d'impact d'une violation de données s'en trouve modifié en conséquence. » Cela transforme la protection des données, d'une simple formalité administrative, en un risque économique quantifiable.
Conclusion
Une donnée isolée, telle une pièce de puzzle égarée, ne révèle que peu de choses et semble sans valeur. C'est pourquoi les individus divulguent régulièrement des informations telles que leur adresse électronique, leur nom et leur numéro de téléphone à des applications, des sites web, des cartes de fidélité et des formulaires en ligne promettant une réduction de 10 %.
Cependant, la valeur des données personnelles se révèle pleinement lorsqu'elles sont agrégées. Si une adresse électronique seule ne vaut que quelques centimes sur les marchés illicites, son association avec d'autres identifiants permet de constituer un profil cohérent et exploitable. Nos résultats indiquent que de telles combinaisons peuvent valoir bien plus que la somme de leurs composantes.
Mais lorsque ces éléments se retrouvent combinés, la situation change. Nos recherches montrent que la combinaison d'une adresse e-mail, d'un nom et d'un numéro de téléphone peut valoir des milliers de fois sa valeur individuelle sur les marchés clandestins. Les pirates n'achètent pas vos données pour la valeur de chaque élément pris séparément, mais pour ce qu'ils permettent de débloquer ensemble. L'affirmation « Je n'ai rien à cacher » suppose que les données restent aussi isolées qu'au moment où vous les avez partagées, ce qui est loin d'être le cas.
Renseignements sur les menaces axés sur l'identité
Suivez l'exposition cumulative des données de votre organisation suite à des violations de données.
Une fuite d'emails semble mineure. Mais si l'on y ajoute des numéros de téléphone issus d'une seconde fuite et des noms provenant d'une troisième, les attaquants détiennent la combinaison la plus précieuse du marché noir : une valeur des milliers de fois supérieure à celle de ses éléments constitutifs. Flare surveille les marchés du dark web, les bases de données de fuites de données et les journaux des voleurs pour détecter l'agrégation des données de votre organisation provenant de différentes sources, avant qu'elles ne soient utilisées à des fins d'usurpation d'identité par échange de carte SIM, d'hameçonnage ciblé ou de prise de contrôle de compte.
Méthodologie
Nous avons exécuté trois modèles de régression pour isoler précisément les points de défaillance des modèles d'évaluation des violations de données.
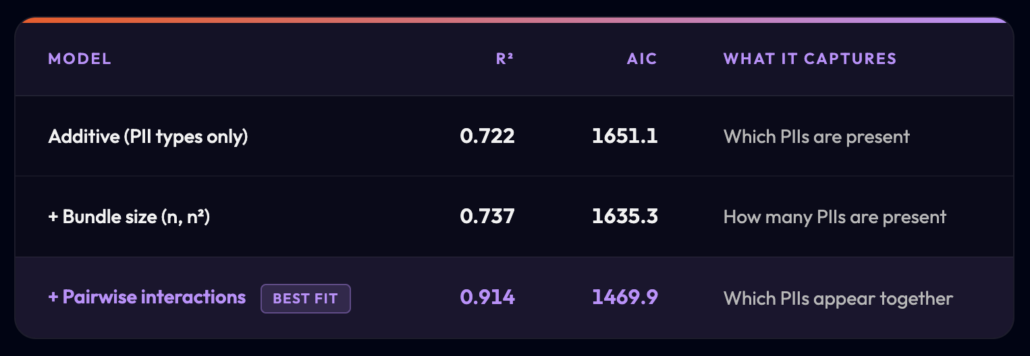
Le passage du modèle de taille de lot au modèle d'interactions par paires est révélateur. L'ajout de la taille de lot n'a qu'un impact minime, le R² passant de 0.722 à 0.737. Autrement dit, le marché se soucie peu du nombre d'informations personnelles identifiables (IPI) impliquées dans une violation de données, qu'elles soient cinq ou huit, si leur combinaison est inappropriée.
L'ajout des interactions par paires (c'est-à-dire les indicateurs clés de performance spécifiques qui apparaissent ensemble) fait passer le R² à 0.914 et réduit l'AIC de 165 points. En d'autres termes, 19.2 % de la variance du prix de rupture s'explique uniquement par la composition du panier de données. Le regroupement est bien plus important que l'indicateur clé de performance pris isolément. Il s'agit du principal facteur déterminant du prix.